Business
Prompt for video faceless
by Mamah chabi Jouvance
3 chapters20 min read
Chapter 1
Fondations du prompting vidéo
Pourquoi le prompt est le scénario de votre vidéo IA
Dans un monde où l'attention se mesure en secondes, une vidéo explicative bien ficelée peut faire la différence entre un prospect conquis et une opportunité manquée. Pourtant, produire ce type de contenu demande traditionnellement du temps, du matériel et des compétences techniques que peu possèdent. L'intelligence artificielle change la donne : elle permet de générer des séquences vidéo professionnelles sans caméra, sans acteur et sans apparaître à l'écran. Mais cette liberté apparente cache une contrainte fondamentale : le résultat dépend entièrement de la qualité du prompt fourni au modèle. Sans consignes précises, l'IA interprète à sa manière, produisant souvent des vidéos génériques, incohérentes ou hors sujet.
Le prompt comme scénario technique
Dans la production vidéo traditionnelle, le scénario définit l'histoire, le storyboard traduit chaque plan en dessin, et le réalisateur indique les mouvements de caméra, l'éclairage et le jeu d'acteur. Dans la génération vidéo par IA, toutes ces fonctions sont condensées dans une seule entité : le prompt textuel. Il ne s'agit plus seulement de décrire ce que l'on veut voir, mais de contraindre le modèle à produire une séquence cohérente, image après image, en respectant une intention précise.
Prenons l'exemple de Sophie Martin, responsable marketing dans une entreprise de formation en ligne. Elle souhaite créer une série de vidéos explicatives pour son cours sur la gestion du temps. Son premier essai ressemble à ceci : « Une personne travaille efficacement au bureau ». Résultat : une séquence où l'on voit tantôt une femme assise devant un ordinateur, tantôt un homme en réunion, tantôt un télétravailleur dans un café — aucune continuité, aucun fil narratif. Le modèle, face à une demande vague, puise aléatoirement dans ses données d'entraînement, produisant un montage décousut qui ne sert aucun objectif pédagogique.
Le problème ici n'est pas technique, mais sémantique. Le sujet (« une personne ») est trop général, l'action (« travaille efficacement ») est abstraite et non visualisable, et le contexte (« au bureau ») manque de spécificité. Chaque image est générée indépendamment, sans lien avec la précédente, ce qui détruit toute cohérence diegétique.
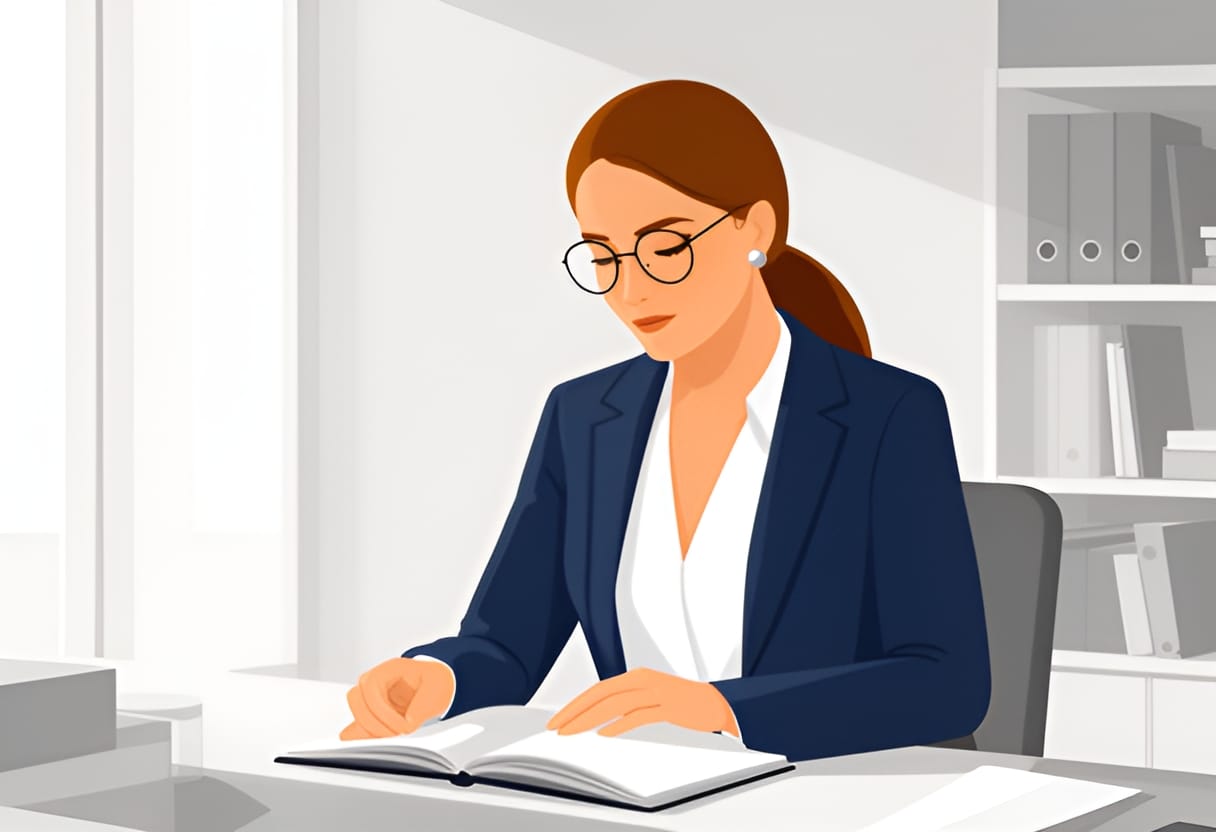
Pour transformer ce prompt faible en une consigne efficace, il faut le décomposer en éléments concrets et interconnectés. Voici une version révisée : « Sophie, une femme de 34 ans aux cheveux châtains attachés en queue de cheval, porte un blazer bleu marine et des lunettes fines. Elle est assise à un bureau ordonné dans un espace de travail moderne, lumière naturelle venant de la gauche. Elle regarde l'écran de son ordinateur, puis prend des notes dans un cahier à spirale, sourit légèrement, et ferme son ordinateur avec détermination. Style réaliste, éclairage doux, plan moyen stable, rythme calme. »
Ce nouveau prompt fonctionne parce qu'il précise :
- Un personnage identifiable (apparence, tenue, âge)
- Une séquence d'actions concrètes et observables
- Un environnement cohérent (bureau ordonné, lumière naturelle)
- Un style visuel et un ton (réaliste, éclairage doux, plan stable)
- Un pacing implicite (gestes lents, expression posée)
Chaque élément guide le modèle vers une interprétation unifiée. Le blazer bleu marine réapparaît sur les plans suivants, la lumière vient toujours de la même direction, les gestes s'enchaînent logiquement. Le résultat n'est plus une série d'images aléatoires, mais une scène crédible qui soutient l'intention narrative : montrer une professionnelle maîtrisant son emploi du temps.
Pourquoi la précision évite les pièges de l'ambiguïté
Les échecs courants du prompting vidéo ne viennent pas d'un manque de créativité, mais d'imprécisions dans trois domaines clés : le sujet, l'action et le style.
- Un sujet mal défini (« un professionnel ») entraîne des variations d'apparence, d'ethnie ou de genre qui nuisent à la reconnaissance du personnage.
- Une action abstraite (« être productif ») ne peut pas être traduite en images ; le modèle comble le vide avec des stéréotypes (poings serrés, regard intense) qui peuvent sembler forcés ou hors contexte.
- Un style omis ou contradictoire (« réaliste mais cartoon ») pousse l'IA à moyenniser entre des représentations incompatibles, générant des artefacts ou des incohérences esthétiques.
Pour éviter ces écueils, il faut traiter le prompt comme un cahier des charges technique : chaque détail compte, non pas pour limiter la créativité, mais pour la canaliser vers un résultat utile. Comme un architecte ne laisse pas au hasard la largeur d'une porte ou la pente d'un toit, le créateur vidéo par IA ne doit rien laisser à l'interprétation lorsqu'il s'agit d'éléments structurants.
Ce niveau de rigueur ne nécessite pas d'expertise technique, mais une habitude à penser en termes observables : que verrait-on réellement si cette scène était filmée ? Quelle tenue porte la personne ? Dans quelle direction vient la lumière ? Quel geste précède lequel ? En répondant à ces questions dans le prompt, on transforme l'IA d'un interprète imprévisible en un exécuteur fidèle d'une vision claire. C'est ce passage du vague au précis qui fait toute la différence entre une vidéo oubliable et un contenu qui fait mouche.
Les cinq piliers expliqués
Pour créer une vidéo IA cohérente et percutante, le prompt doit intégrer cinq dimensions essentielles : l’intention narrative, le style visuel, la description des personnages, l’environnement et le mouvement/pacing. Chacun de ces piliers agit comme un levier pour guider le modèle vers une interprétation unifiée, réduisant l’ambiguïté et renforçant la diegèse.
L’intention narrative définit le pourquoi de la vidéo : quel message doit-elle transmettre ? Dans le cas de Sophie Martin, il s’agit de montrer comment une professionnelle gère son temps avec méthode. Sans cette intention clairement exprimée, le modèle peut produire des images jolies mais dénuées de sens pédagogique.
Le style visuel détermine comment la scène est rendue : réaliste, animé, documentaire, cinématographique ? Une omission fréquente conduit à un rendu par défaut, souvent trop générique ou inadapté au contexte professionnel. Par exemple, un style « réaliste » avec éclairage doux et plans stables convient mieux à une formation qu’un style « cartoon » ou « cyberpunk ».
La description des personnages va au-delà de l’apparence : elle inclut l’âge, la tenue, la coiffure, les accessoires et même l’expression faciale. Chez Sophie, préciser qu’elle porte un blazer bleu marine et des lunettes fines permet au modèle de maintenir une cohérence vestimentaire et physique d’un plan à l’autre.
L’environnement ancre la scène dans un lieu crédible : un bureau ordonné, une lumière naturelle venant de la gauche, un cahier à spirale. Ces détails empêchent le modèle de basculer aléatoirement entre un open space, un café ou une salle de réunion.
Enfin, le mouvement et le pacing décrivent le rythme des actions : gestes lents, expressions posées, transitions fluides. En spécifiant que Sophie « regarde l’écran, puis prend des notes, sourit légèrement, et ferme son ordinateur avec détermination », on crée une séquence logique où chaque action prépare la suivante.
Exemple concret : une vidéo sur les énergies renouvelables
Prenons le cas d’Alex Dubois, enseignant en ligne souhaitant expliquer le fonctionnement d’une éolienne. Son premier prompt : « Une éolienne tourne dans un champ sous un ciel bleu. » Résultat : des éoliennes de tailles variées, parfois en mer, parfois en montagne, avec des ciels nuageux ou coucher de soleil — aucune cohérence technique ou visuelle.
En appliquant le cadre des cinq piliers, son prompt devient : « Intention : montrer comment une éolienne terrestre convertit le vent en électricité pour un public pédagogique. Style : réaliste, lumière naturelle douce, plan moyen fixe, rendu 4K. Personnage : aucun personnage humain, mais l’éolienne doit être clairement identifiable comme un modèle industriel à trois pales, hauteur 80m, couleur blanc mat, située dans un champ agricole plat avec des lignes de culture visibles. Environnement : champ de blé vert pâle sous un ciel partiellement nuageux, lumière venant de l’avant-left (10h), sol légèrement humide reflétant le ciel. Mouvement : rotation lente et régulière des pales (environ 1 tour toutes les 4 secondes), léger frémissement des tiges de blé au vent, aucun changement de plan ni zoom. »
Ce prompt garantit que l’éolienne garde la même apparence, que le champ ne se transforme pas en océan, et que le rythme reste adapté à une explication calme et claire.
Tableau comparatif : impact de l’absence d’un pilier
| Pilier omis | Conséquence sur le résultat généré | Exemple concret |
|---|---|---|
| Intention narrative | Vidéo esthétique mais vide de sens pédagogique | Une belle éolienne qui tourne, sans explication de son fonctionnement |
| Style visuel | Rendu par défaut (souvent trop artistique ou irréaliste) | Éolienne représentée en aquarelle ou en style cyberpunk |
| Personnages / sujet | Incohérence d’apparence ou de type d’objet | Éolienne passant d’un modèle terrestre à une éolienne flottante en mer |
| Environnement | Changement brusque de lieu ou de conditions | Champ devenant soudainement un désert ou une plage |
| Mouvement / pacing | Rythme saccadé, zooms inattendus, actions non liées | Pales tournant à vitesse variable, coupures brutales, zoom sur un oiseau |
Try This : Appliquez les cinq piliers cette semaine
- Choisissez une idée de vidéo explicative simple (ex : « comment faire un cv efficace » ou « les bases de l’intérêt composé »).
- Écrivez un premier prompt en une phrase, puis enrichissez-le en ajoutant délibérément chacun des cinq piliers : intention, style, personnage(s), environnement, mouvement.
- Générez la vidéo avec votre outil préféré et notez ce qui s’est amélioré : la cohérence du personnage/objet, la pertinence du style, la fluidité de l’action.
Key Takeaways
- Un prompt vidéo efficace doit intégrer cinq piliers : intention narrative, style visuel, personnages, environnement et mouvement/pacing.
- Chaque pilier réduit une forme d’ambiguïté qui pourrait autrement fragmenter la cohérence diegétique de la vidéo.
- L’omission du style visuel entraîne souvent un rendu par défaut inadapté aux contextus professionnels ou pédagogiques.
- La précision dans la description des personnages et de l’environnement permet une cohérence visuelle d’un plan à l’autre.
- Spécifier le mouvement et le pacing transforme une suite d’images statiques en une séquence crédible et rythmée.
Chapter 2
Maîtriser les personnages et les environnements
Créer des personnages cohérents sans montrer leur visage
Sophie Martin ajuste sa lunette fine et fixe l’écran de son ordinateur. Elle veut transformer son idée de cours en vidéo, mais sans apparaître à l’écran. Comment faire ressentir la présence d’une formatrice compétente sans jamais montrer son visage ? Cette question est au cœur des vidéos « faceless », où la cohérence du personnage se joue dans les détails subtils.
Construire une identité visuelle sans visage
Dans une vidéo sans visage, le personnage n’est pas absent — il est suggéré. La cohérence repose sur des éléments récurrents que l’IA peut reconnaître et reproduire d’un plan à l’autre : la tenue vestimentaire, les accessoires, le langage corporel et le contexte d’action. Ces indices permettent au spectateur de reconnaître la même personne, même si son visage reste hors champ.
Prenons Sophie. Au lieu de décrire « une femme qui travaille », elle précise : une femme de 34 ans, cheveux châtains attachés en queue de cheval, portant un blazer bleu marine et des lunettes fines. Elle est assise à un bureau ordonné, la lumière naturelle venant de la gauche. Ses gestes sont répétés : regard vers l’écriture, prise de notes dans un cahier à spirale, léger sourire, puis extinction déterminée de l’ordinateur. Ces détails, associés à l’environnement, créent une signature visuelle stable.
Sans cette précision, l’IA génère des variantes incohérentes : parfois une femme plus âgée, parfois un homme, parfois des vêtements différents d’un plan à l’autre. La reconnaissance du personnage se perd, et avec elle, la confiance du spectateur.
Niveaux de description de personnage : du vague au précis
Plus la description du personnage est détaillée, plus la cohérence diegétique est forte. Le tableau ci-dessous illustre quatre niveaux de précision, du plus vague au plus opérationnel pour une série de vidéos pédagogiques.
| Niveau de description | Exemple de prompt | Impact sur la cohérence | Adapté à |
|---|---|---|---|
| Vague | « Une personne travaille au bureau » | Apparence, âge, gestes et vêtements changent d’un plan à l’autre | Aucun usage professionnel |
| Général | « Une femme d’âge moyen travaille à un bureau » | Quelques éléments stables (genre, lieu), mais imprécision sur l’apparence et les gestes | Idées préliminaires, tests rapides |
| Précis | « Une femme de 34 ans, cheveux châtains en queue de cheval, blazer bleu marine, lunettes fines, prend des notes à un bureau ordonné » | Apparence et gestes répétés, environnement stable | Vidéo unique ou pilote |
| Très précis (idéale pour série) | « Sophie Martin, 34 ans, responsable marketing, cheveux châtains en queue de cheval, blazer bleu marine, lunettes fines, assise à un bureau moderne avec lumière de gauche, regarde l’écran, prend des notes dans un cahier à spirale, sourit légèrement, éteint son ordinateur avec détermination » | Identité visuelle stable, gestes récurrents, reconnaissance immédiate | Série de vidéos, marque personnelle |
Ce niveau de détail transforme une simple action en une signature reconnaissable. Dans une série sur la gestion du temps, chaque vidéo peut commencer par Sophie qui ajuste ses lunettes, termine par l’extinction de son ordinateur, et maintenir les mêmes vêtements et posture. Le spectateur reconnaît immédiatement la formatrice, même sans voir son visage.
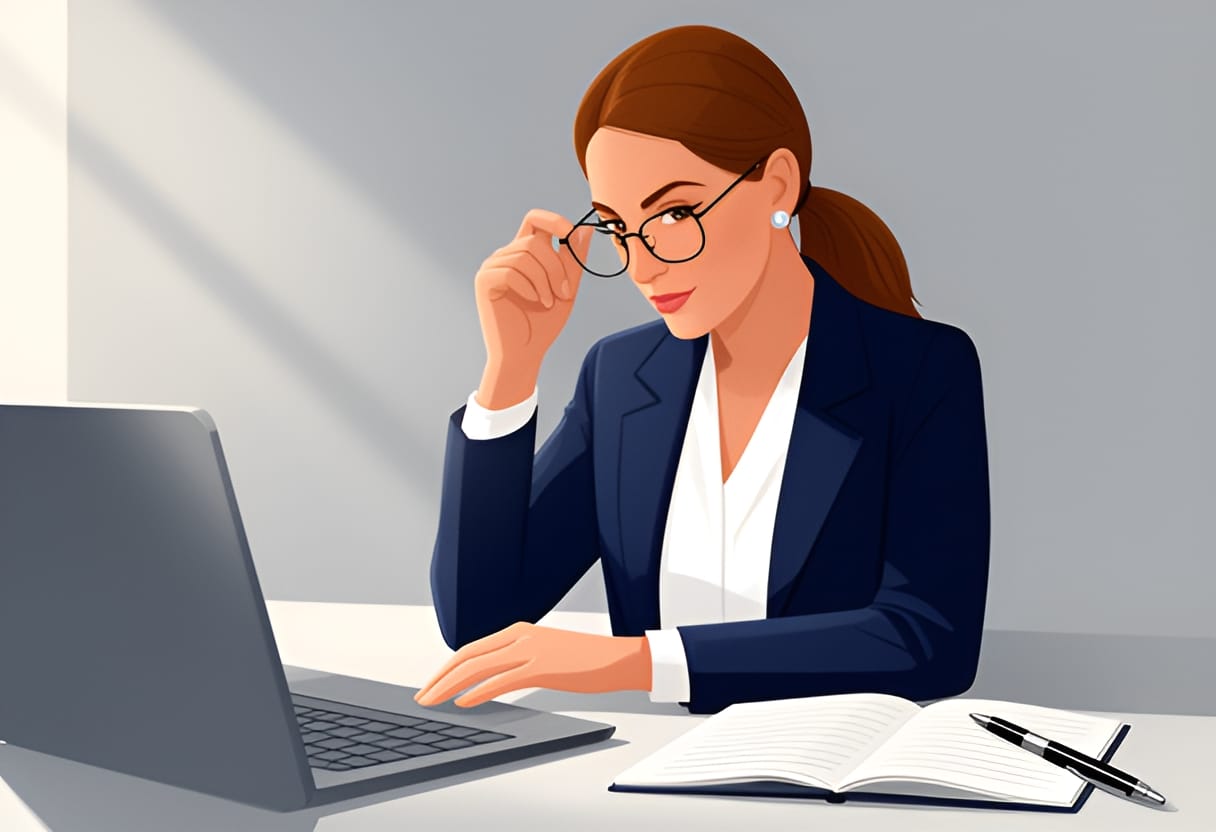
Pour appliquer cela, commencez par définir trois éléments récurrents : un vêtement distinctif (comme un blazer ou un foulard), un geste répété (prendre des notes, pointer du doigt) et un contexte constant (type de bureau, direction de la lumière). Répétez-les dans chaque prompt pour construire une présence fiable.
Construire des environnements qui racontent une histoire
Un environnement bien choisi ne se contente pas d'encadrer l'action : il parle. Dans une vidéo explicative, le décor peut renforcer le message, suggérer l'expertise ou créer une atmosphère propice à l'apprentissage, le tout sans un seul mot supplémentaire. Pour y parvenir, il faut aller au-delà de la simple description d'une pièce et penser l'environnement comme un élément narratif actif.
Définir un lieu avec intention
Un arrière-plan générique comme « un bureau » ou « une salle » laisse trop de place à l'interprétation de l'IA, ce qui peut entraîner des incohérences ou des distractions. À l'inverse, un lieu spécifié avec précision ancre la scène dans un univers crédible et soutient la thématique de la vidéo.
Prenons l'exemple d'Alex Dubois, qui souhaite expliquer le fonctionnement d'une éolienne. Un prompt vague tel que « un homme explique près d'une éolienne » risque de produire des scènes où l'éolienne apparaît parfois en zone urbaine, parfois en mer, avec des vêtements inadaptés ou un éclairage incohérent. En affinant la description, Alex obtient un résultat bien plus fidèle à son intention :
« Alex Dubois, 29 ans, enseignant en ligne, vêtu d'une veste kaki et d'un casque de sécurité blanc, se tient au pied d'une éolienne terrestre moderne dans un champ ouvert sous un ciel partiellement nuageux, lumière douce de fin d'après-midi, explique les pales en rotation avec un geste de la main droite. »
Ici, chaque détail contribue à la cohérence : le type d'éolienne (terrestre, moderne), le lieu (champ ouvert), l'heure de la journée (fin d'après-midi), l'éclairage (lumière douce) et même l'équipement du personnage (casque de sécurité) renforcent la plausibilité de la scène. Le spectateur reconnaît immédiatement le contexte technique et éducatif, sans qu'Alex ait besoin de le préciser à l'oral.
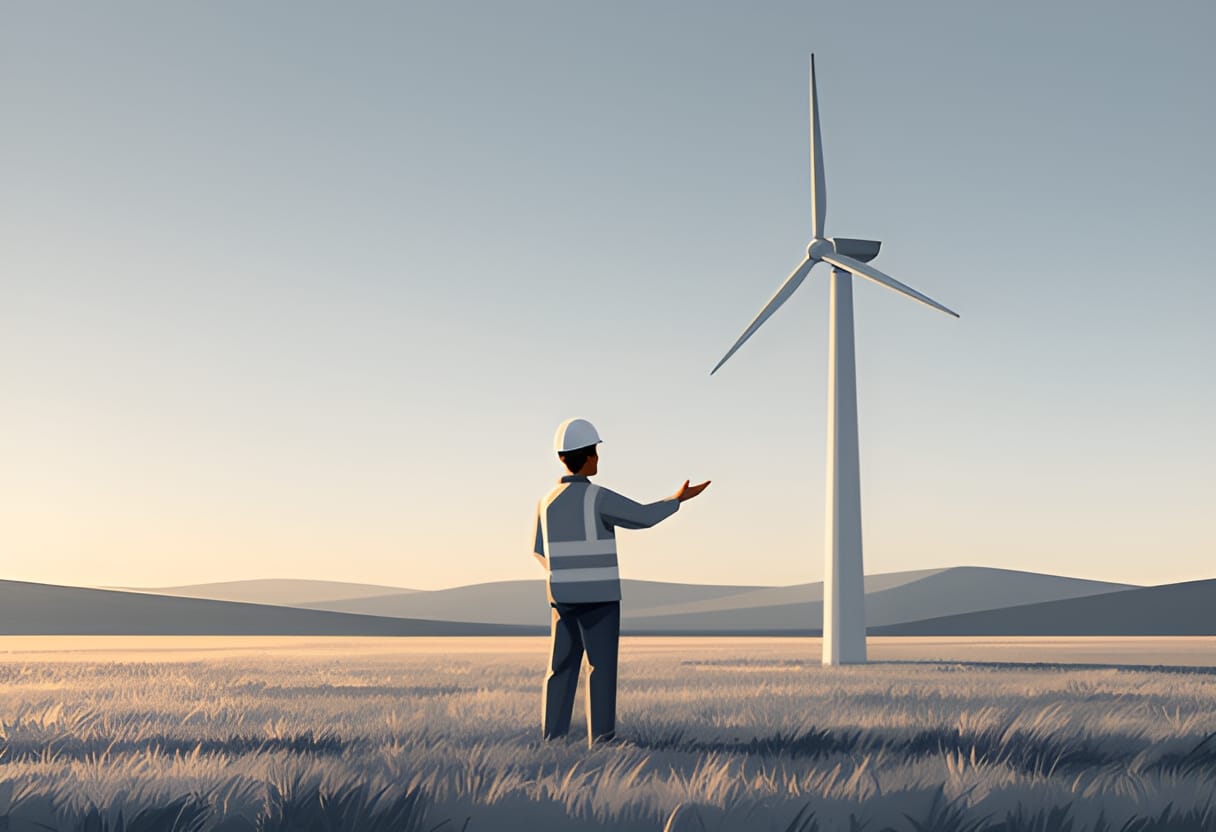
Pour appliquer cette approche, commencez par identifier le lieu idéal pour votre sujet : un laboratoire pour la biologie, une cuisine pour la nutrition, un atelier pour le bricolage. Puis, ajoutez deux à trois détails spécifiques qui évoquent l'expertise ou l'activité : un microscope sur une paillasse, des casseroles en cuivre accrochées, un établi avec des outils rangés. Ces éléments agissent comme des indices silencieux qui guident la compréhension.
Trois types d'environnements selon leur fonction narrative
Tous les environnements ne servent pas le même objectif. Selon le message à faire passer, certains décors sont plus adaptés que d'autres. Le tableau suivant classe trois catégories d'environnements en fonction de leur coût cognitif pour le spectateur — c'est-à-dire l'effort nécessaire pour les interpréter — et de leur pertinence selon le type de communication.
| Type d'environnement | Exemple | Coût cognitif | Meilleur pour |
|---|---|---|---|
| Neutre | Bureau ordonné, mur clair, lumière naturelle | Faible | Vidéos explicatives générales, présentations claires où le fond ne doit pas distraire |
| Thématique | Laboratoire avec éprouvettes, cuisine avec ingrédients visibles, atelier avec bois sciés | Moyen | Vidéos spécialisées où le décor renforce la crédibilité du sujet (science, cuisine, bricolage) |
| Métaphorique | Arbre aux racines visibles pour la croissance personnelle, boîte engrenages pour la pensée systémique | Élevé | Vidéos conceptuelles ou inspirantes où l'environnement symbolise une idée abstraite |
Un environnement neutre minimise la charge visuelle et convient parfaitement aux vidéos où l'accent doit rester sur le geste ou l'expression (même suggérée). Un environnement thématique, en revanche, agit comme un témoin silencieux de l'expertise du présentateur : voir des livres sur une étagère ou un tableau blanc rempli de schémas suggère immédiatement un contexte de connaissance sans qu'il soit nécessaire de le dire.
Enfin, un environnement métaphorique demande plus d'interprétation, mais peut être puissant pour ancrer une idée abstraite dans une image mémorable. Cependant, son usage doit être maîtrisé : trop d'ambiguïté risque de perdre le spectateur, surtout dans un format court où chaque seconde compte.
Pour choisir le bon type d'environnement, demandez-vous : le décor doit-il simplement soutenir l'action, prouver une compétence, ou illustrer une idée ? Votre réponse guidera le niveau de détail et de symbolisme nécessaire.
Try This
Cette semaine, prenez une idée de vidéo explicative simple (comme « comment rédiger un sujet d'email efficace » ou « les trois règles du entretien d'embauche ») et travaillez son environnement :
- Décrivez le lieu le plus adapté à votre sujet en une phrase précise (ex : « un espace de travail moderne avec un ordinateur portable ouvert et un carnet de notes »).
- Ajoutez deux détails spécifiques qui renforcent la crédibilité ou l'intention (ex : « une tasse de café à moitié vide », « un tableau blanc avec des mots barrés et réécrits »).
- Réécrivez votre prompt en intégrant ces éléments, puis générez une courte séquence. Observez si l'environnement semble cohérent et utile à la compréhension.
Key Takeaways
- Un environnement efficace combine spécificité spatiale et détails évocateurs pour soutenir le récit sans mots.
- Répéter des éléments de décor (lumière, objets, agencement) d'un plan à l'autre renforce la cohérence diegétique.
- Choisissez le type d'environnement (neutre, thématique, métaphorique) selon l'objectif de votre vidéo et la charge cognitive souhaitée pour le spectateur.
Chapter 3
Langage cinématographique et itération professionnelle
Traduire les mouvements de caméra en prompts texte
Le langage cinématographique donne vie aux vidéos générées par l'IA, transformant une simple description statique en une expérience dynamique et engageante. Sans ces indications, même le prompt le plus détaillé risque de produire des séquences figées, dépourvues de rythme et d'intention narrative. En intégrant des mouvements de caméra précis, on guide l'IA vers une mise en scène réfléchie, où chaque plan sert un objectif clair — qu'il s'agisse de révéler une information, de suivre une action ou de créer une atmosphère.
Principes de traduction des mouvements en texte
Dans le prompting vidéo, les mouvements de caméra ne se décrivent pas comme des instructions techniques réservées à un opérateur, mais comme des observations sensorielles : ce que la caméra voit et comment elle le voit. Cette approche s'appuie sur des verbes d'action forts (glisser, s'élever, approcher) associés à des adverbes de manière (lentement, fluide, déterminé) pour qualifier le mouvement. Par exemple, au lieu de dire « faire un travelling vers la droite », on écrit « un travelling latéral fluide de gauche à droite suivant une main qui écrit sur un tableau noir ». Cette formulation indique non seulement la direction et la qualité du mouvement, mais aussi son sujet d'attention, ce qui aide l'IA à maintenir la cohérence diegétique.
Un autre élément clé est la durée implicite du mouvement. Un « zoom progressif » suggère une transition lente et soutenue, tandis qu'un « panoramique rapide » implique une révélation soudaine. Ces nuances influencent directement le ton de la séquence : un mouvement lent évoque la contemplation ou la solennité, tandis qu'un mouvement rapide peut signaler l'urgence ou la découverte. En reliant ces choix à l'intention pédagogique ou émotionnelle de la vidéo, on transforme le langage cinématographique en un levier de communication efficace.
Tableau des mouvements de caméra et leurs équivalents en prompt
Les cinq mouvements de caméra suivants sont parmi les plus utiles pour les vidéos explicatives générées par l'IA. Chacun peut être traduit en une formule de prompt testée, associée à un effet typique sur la perception du spectateur.
| Mouvement de caméra | Formule de prompt type | Effet émotionnel ou informatif |
|---|---|---|
| Travelling latéral | « un travelling latéral fluide de gauche à droite suivant [sujet en action] » | Guide l'attention à travers une scène, montre un processus ou un déplacement logique |
| Panoramique | « un panoramique lent de bas en haut révélant [élément de décor] » | Révèle progressivement un environnement, crée une montée en puissance ou un sentiment d'échelle |
| Zoom avant | « un zoom progressif vers [objet ou détail] » | Met l'accent sur un élément clé, souligne une information importante |
| Travelling avant | « un travelling avant stable approaching [personne ou objet] » | Crée de l'intimité ou de l'immersion, suggère une approche ou une confrontation douce |
| Inclinaison (tilt) | « une inclinaison verticale lente du sol au ciel [ou inversé] » | Met en contraste deux éléments (ex : sol et toit), souligne une transformation ou une élévation |
Prenons l'exemple d'Alex Dubois, qui souhaite expliquer le fonctionnement d'une éolienne. Un premier prompt comme « une éolienne tournant dans un champ » produit souvent une image statique ou incohérente. En intégrant un mouvement de caméra, le prompt devient : « un travelling latéral lent de droite à gauche suivant les pales d'une éolienne moderne tournant doucement dans un champ vallonné sous un ciel nuageux, lumière douce de fin d'après-midi ». Cette version ne se contente pas de décrire l'objet : elle entraîne le spectateur dans une observation suivie, où le mouvement révèle progressivement la mécanique de l'objet tout en établissant un cadre paisible propice à la compréhension.
De même, pour montrer l'intérieur d'une nacelle d'éolienne, un « zoom progressif vers le tableau de bord affichant les données de production » attire l'attention sur l'élément technique clé, tandis qu'un « panoramique lent de gauche à droite révélant l'étroitesse de l'espace et les commandes essentielles » permet de situer l'utilisateur dans un environnement réel et fonctionnel. Ces choix ne sont pas anodins : ils transforment une simple illustration en une séquence narrative qui guide la compréhension étape par étape.
Un cadre de travail pour itérer et progresser
Le passage du tâtonnement à la maîtrise dans le prompting vidéo repose sur une méthode structurée, reproductible et mesurable. Plutôt que de générer des vidéos au hasard et d'espérer un résultat satisfaisant, le créateur bénéficie d'un cadre en cinq étapes qui transforme chaque itération en une opportunité d'apprentissage ciblé. Ce cadre s'applique aussi bien à Sophie Martin souhaitant expliquer la gestion du temps qu'à Alex Dubois détaillant le fonctionnement d'une éolienne.
Le cadre en cinq étapes : formuler, générer, analyser, affiner, documenter
Chaque cycle d'amélioration suit une séquence logique qui ancre la créativité dans l'observation et l'ajustement éclairé.
Formuler Commencer par un prompt clair, basé sur les cinq piliers établis dans les chapitres précédents : narration, personnage, environnement, style visuel et langage cinématographique. Le prompt doit être spécifique sans être surchargé. Par exemple, pour Sophie Martin : « Une femme de 34 ans, cheveux châtains en queue de cheval, blazer bleu marine et lunettes fines, assise à un bureau ordonné dans un espace de travail moderne avec lumière naturelle venant de la gauche, regardant son écran d'ordinateur, prenant des notes dans un cahier à spirale, souriant légèrement, puis éteignant son ordinateur avec détermination, style réaliste, éclairage doux, plan moyen stable, rythme calme. » Un premier jet peut être plus court, mais il doit inclure suffisamment de détails pour éviter l'ambiguïté.
Générer Utiliser l'outil choisi (Runway, Pika, Sora, etc.) avec les paramètres recommandés : résolution adaptée, nombre d'itérations limité (généralement 1 à 3 par version de prompt), et durée de vidéo cohérente avec l'objectif (15 à 30 secondes pour une séquence explicative). Conserver les mêmes réglages entre les essais pour isoler l'impact du prompt.
Analyser Observer la vidéo générée avec un regard critique, en se posant des questions précises :
- Les actions de Sophie sont-elles dans le bon ordre et clairement visibles ?
- Le personnage ressemble-t-il à la description (âge, tenue, coiffure) ?
- L'environnement est-il cohérent (bureau ordonné, lumière de gauche) ?
- Le rythme et les mouvements de caméra soutiennent-ils l'intention pédagogique ?
Noter les écarts de façon objective, sans jugement de valeur. Par exemple : « Le personnage porte un blazer gris au lieu de bleu marine » ou « Le sourire apparaît trop tard dans la séquence ».
Affiner Modifier le prompt en corrigeant un ou deux éléments à la fois. Jamais tout d'un coup. Si le blazer est mauvais, on précise : « blazer bleu marine, pas gris ». Si l'action est manquante, on ajoute : « elle commence à prendre des notes après avoir regardé l'écran ». Chaque modification doit être traçable pour comprendre son effet.
Documenter Consigner chaque essai dans un tableau de suivi personnel. Cela permet de voir les tendances, d'éviter de répéter les mêmes erreurs et de capitaliser sur ce qui fonctionne.
| Version du prompt | Modification apportée | Résultat observé | Leçon apprise |
|---|---|---|---|
| V1 : description de base | — | Personnage générique, environnement flou | Trop vague, manque de spécificité sur l'apparence |
| V2 | Ajout de l'âge, cheveux, blazer | Meilleur personnage, mais environnement incohérent | Le lieu doit être décrit avec autant de précision que le personnage |
| V3 | Précision sur le bureau ordonné, lumière de gauche | Environnement correct, mais pas d'actions visibles | Les actions doivent être séquencées et clairement situées dans le temps |
| V4 | Séquence d'actions : regard → notes → sourire → arrêt | Toutes les actions présentes, ordre respecté | Le découpage temporel dans le prompt guide la génération |
Ce tableau devient un journal de bord qui oriente les prochains essais et révèle les leviers les plus efficaces pour améliorer la cohérence.
Plan d'action de 30 jours : appliquer le cadre à un projet réel
Pour transformer l'essai en habitude, voici un plan progressif adapté aux objectifs de Sophie et d'Alex, avec des livrables hebdomadaires concrets.
Semaine 1 : maîtriser les personnages Objectif : produire une vidéo où le personnage principal est clairement identifiable et cohérent sur le plan physique et vestimentaire. Livrable : une séquence de 15 secondes montrant Sophie Martin (ou un personnage similaire) effectuant une action simple (prendre des notes) avec une apparence constante. Action : utiliser le cadre en cinq étapes, se concentrer uniquement sur l'apparence et la consistance du personnage. Documenter au moins trois essais.
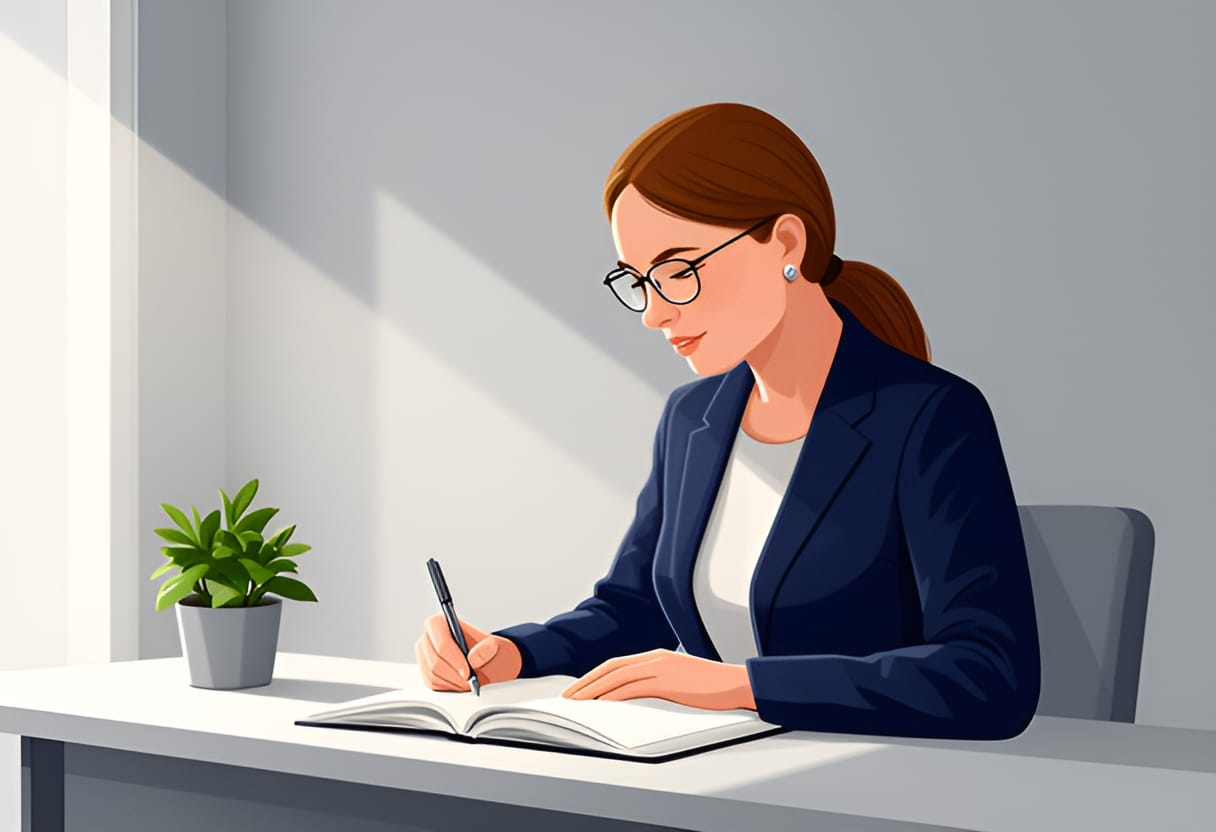
Semaine 2 : maîtriser les environnements Objectif : assurer que le lieu soit reconnu comme un espace de travail moderne avec lumière naturelle de gauche, sans éléments contradictoires (fenêtre à droite, bureau en désordre). Livrable : même séquence que la semaine précédente, mais avec un environnement parfaitement cohérent. Action : reprendre le meilleur prompt de la semaine 1, affiner uniquement la description de l'environnement. Noter comment les détails spatiaux influencent la perception de réalisme.
Semaine 3 : maîtriser le langage cinématographique Objectif : intégrer un mouvement de caméra pertinent qui soutient la narration (par exemple, un zoom progressif sur le cahier lors de la prise de notes). Livrable : vidéo de 15 à 20 secondes avec personnage, environnement et mouvement de caméra fluide et intentionnel. Action : ajouter une formule de mouvement testée (comme « un zoom progressif vers le cahier où elle écrit ») et observer son effet sur l'attention et le rythme.
Après ces trois semaines, le lecteur dispose d'une base solide. Les deux semaines suivantes peuvent être dédiées à la création d'une première séquence explicative complète (par exemple, « comment prioriser ses tâches ») en appliquant l'ensemble du cadre. Le plan d'action se termine par une révision du tableau de suivi et la définition d'un prochain objectif : créer une série de trois vidéos sur un thème choisi.
Try This
Cette semaine, appliquez le cadre en cinq étapes à une idée simple :
- Formulez un prompt de base pour montrer une personne expliquant un concept (ex : « comment faire un bon café »).
- Générez la vidéo, notez trois écarts entre le prompt et le résultat.
- Affinez le prompt en corrigeant un seul élément (apparence, environnement ou action) et relancez l'essai.
Key Takeaways
- La maîtrise du prompting vidéo s'acquiert par des cycles répétés de formulation, génération, analyse, affinement et documentation.
- Un tableau de suivi personnalisé transforme l'expérience en apprentissage mesurable et évite les répétitions d'erreurs.
- Un plan d'action progressif, centré sur une compétence par semaine, permet de construire une expertise solide et durable.
- Chaque itération doit modifier un seul élément du prompt pour en mesurer l'impact avec précision.
- Le langage cinématographique, lorsqu'il est intégré intentionnellement, transforme une illustration statique en une séquence narrative qui guide la compréhension.